Jonas schreibt
Lade die Datei bde_export.csv und zeig mir, welche Spalten drin sind und wie die ersten Zeilen aussehen.
KI & Automatisierung · Beispiel aus der Praxis
Jeder Betrieb sitzt auf Jahren von Daten, die niemand auswertet, weil zwischen Frage und Antwort ein Entwickler steht. Mit dem Werkzeug der Data Scientists – einem Notebook, Python und einem KI-Assistenten, der das Tippen übernimmt – macht ein Betriebswirt die Auswertung selbst. Wir zeigen es an einer Frage: Wo ist der Engpass?
Ausgangslage
Von der Durchlaufzeit eines Auftrags ist in vielen Fertigungen nur ein kleiner Teil Bearbeitung. Der Rest ist Warten – vor einer Maschine, auf Material, auf eine Freigabe. Diese Liegezeit steht in keiner Kalkulation, und genau sie entscheidet über Liefertermine. Nach der Theory of Constraints ist sie außerdem das verlässlichste Signal für den Engpass: Vor ihm stapeln sich die Aufträge, hinter ihm ist Luft.
Die Daten dafür sind da. Jede BDE bucht „Beginn" und „Ende" je Arbeitsgang. Die Liegezeit vor Arbeitsgang 30 ist schlicht der Abstand zwischen dem Ende von Arbeitsgang 20 und dem Beginn von 30 – für jeden Auftrag, seit Jahren. Niemand schaut darauf, weil das ERP diese Auswertung nicht hat und weil der Weg über Excel bei einigen hunderttausend Stempeln endet.
Und: BDE-Stempel lassen sich mit zwei Handgriffen zu anonymen Betriebsdaten machen. Personalnummer raus – die braucht niemand für Liegezeiten. Auftragsnummern durchnummerieren, falls sie Kunden erkennen lassen; Artikelnummern ebenso, falls sie sprechend sind. Übrig bleiben Arbeitsplatz, Arbeitsgang, Zeitstempel, Menge. Keine Kunden, keine Preise, keine Namen. Damit fallen die Daten in die unkritischste Klasse, und man kann sie mit jedem KI-Assistenten bearbeiten, auch einem der großen Anbieter.
Werkzeug
JupyterLab ist eine Arbeitsumgebung im Browser, aufgebaut aus Zellen: In eine Zelle schreibt man eine Anweisung, darunter erscheint das Ergebnis – eine Tabelle, ein Diagramm, eine Zahl. Die Anweisungen sind Python. Das war bis vor kurzem die Hürde. Heute sitzt ein KI-Assistent im Notebook: Man beschreibt in einem Satz, was man sehen will, der Assistent schreibt die Zelle, führt sie aus, und man sieht das Ergebnis. Der Python-Code bleibt sichtbar, aber man muss ihn weder schreiben noch lesen.
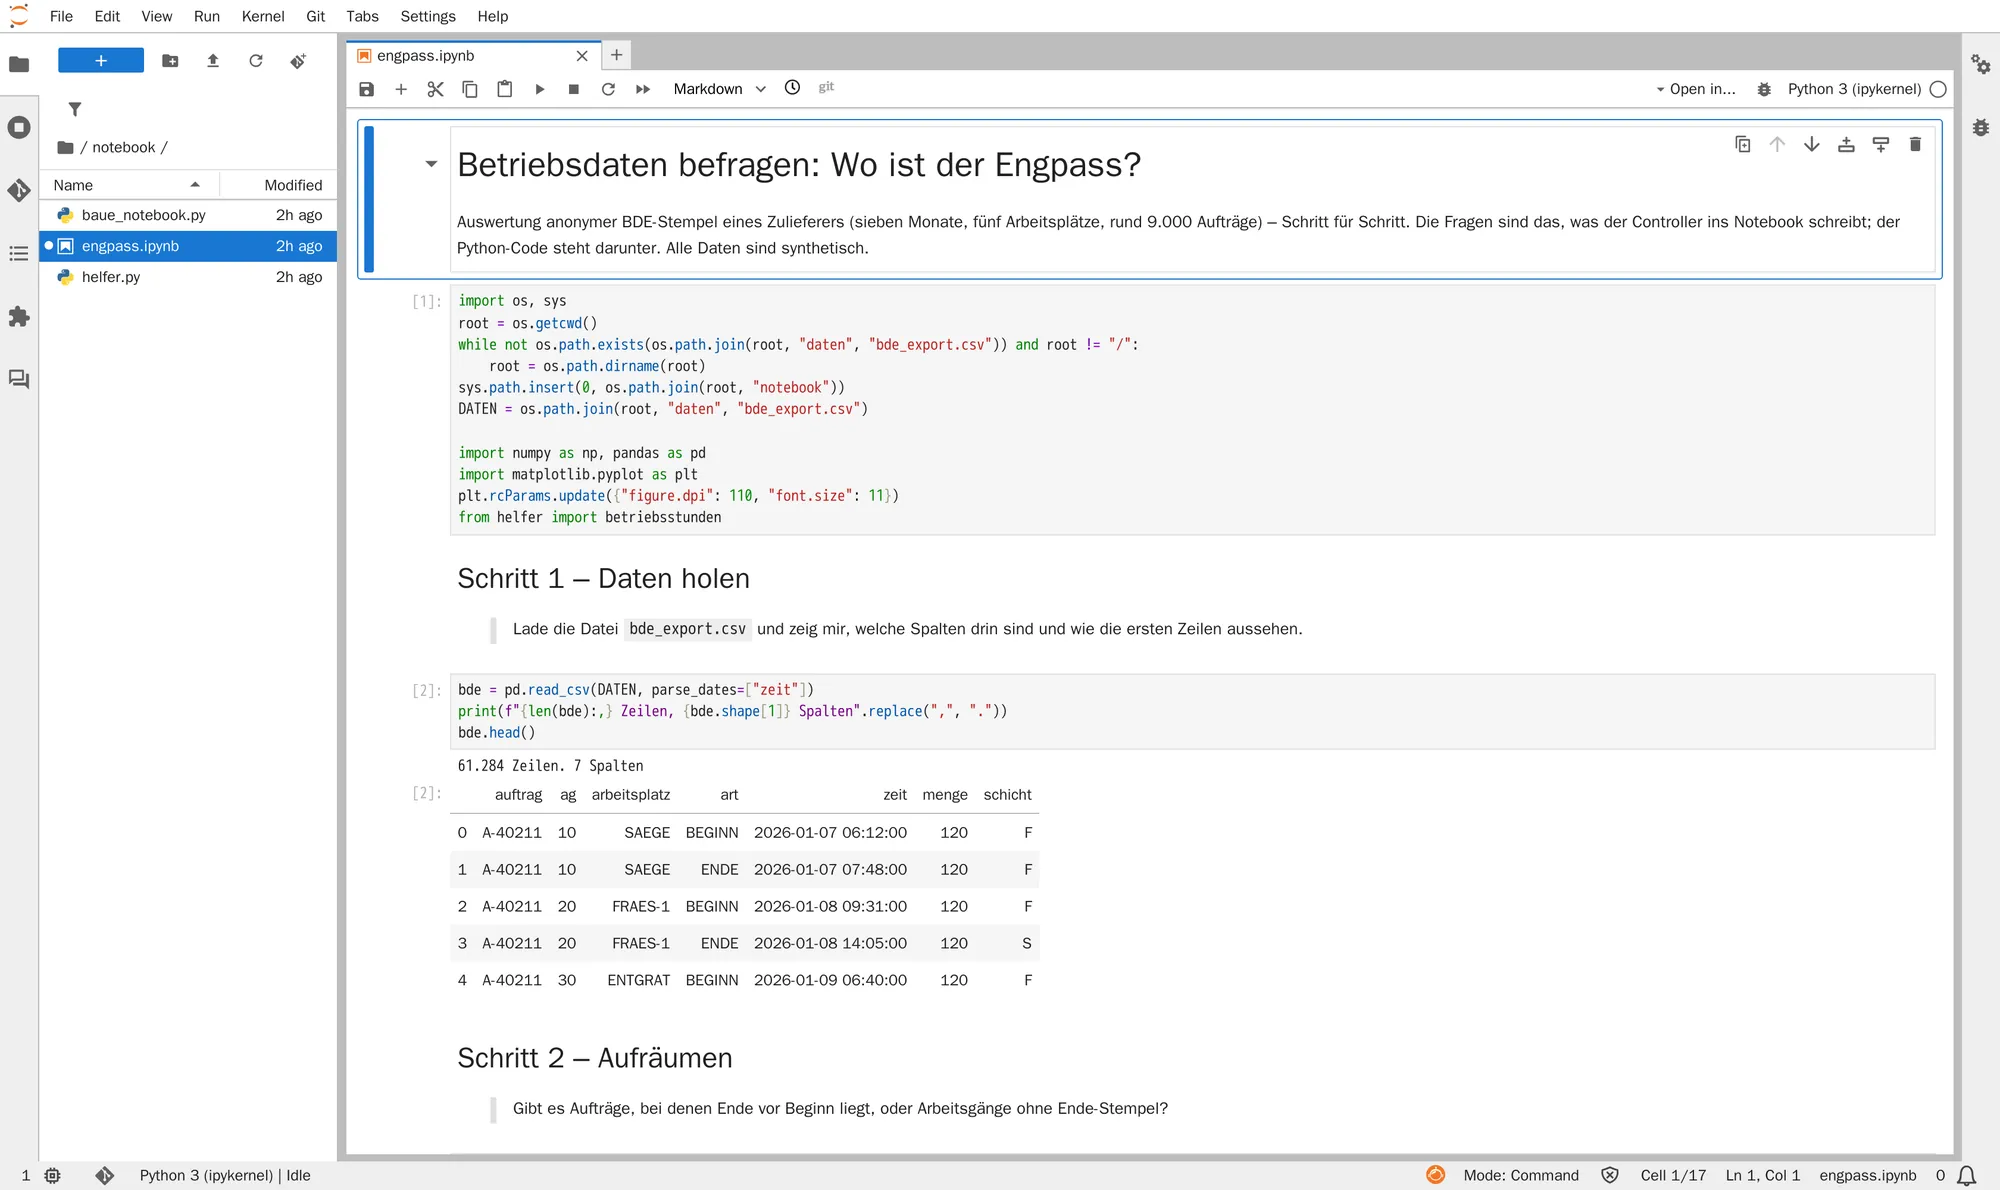
engpass.ipynb mit Frage (Markdown), Python-Zelle und der Tabelle der ersten BDE-Zeilen.Das ist ein anderer Arbeitsmodus als ein Chat. Die Daten bleiben geladen, jeder Schritt baut auf dem vorigen auf, und das fertige Notebook ist gleichzeitig Dokumentation: jede Frage, jede Antwort, jedes Diagramm in der Reihenfolge ihres Entstehens. Eine Excel-Datei mit zwölf Tabs und drei Versionen wird hier zu einem Dokument mit einer Geschichte.
Was folgt, ist sein Ablauf über eine Woche. Die Zitate sind das, was er in das Notebook schreibt. Die Daten sind ein anonymisierter Export: sieben Monate, fünf Arbeitsplätze, rund 9.000 Aufträge.
Schritt 1
Jonas schreibt
Lade die Datei bde_export.csv und zeig mir, welche Spalten drin sind und wie die ersten Zeilen aussehen.
Der Assistent
Die Datei hat 61.284 Zeilen und 7 Spalten. Zeitstempel habe ich als Datum erkannt.
import pandas as pd
bde = pd.read_csv("bde_export.csv", parse_dates=["zeit"])
bde.head()
auftrag ag arbeitsplatz art zeit menge schicht A-40211 10 SAEGE BEGINN 2026-01-07 06:12:00 120 F A-40211 10 SAEGE ENDE 2026-01-07 07:48:00 120 F A-40211 20 FRAES-1 BEGINN 2026-01-08 09:31:00 120 F A-40211 20 FRAES-1 ENDE 2026-01-08 14:05:00 120 S A-40211 30 ENTGRAT BEGINN 2026-01-09 06:40:00 120 F
Die Frage tippt Jonas nicht ins Notebook, sondern in die Chat-Seitenleiste; der Assistent schreibt die Zelle und führt sie aus.
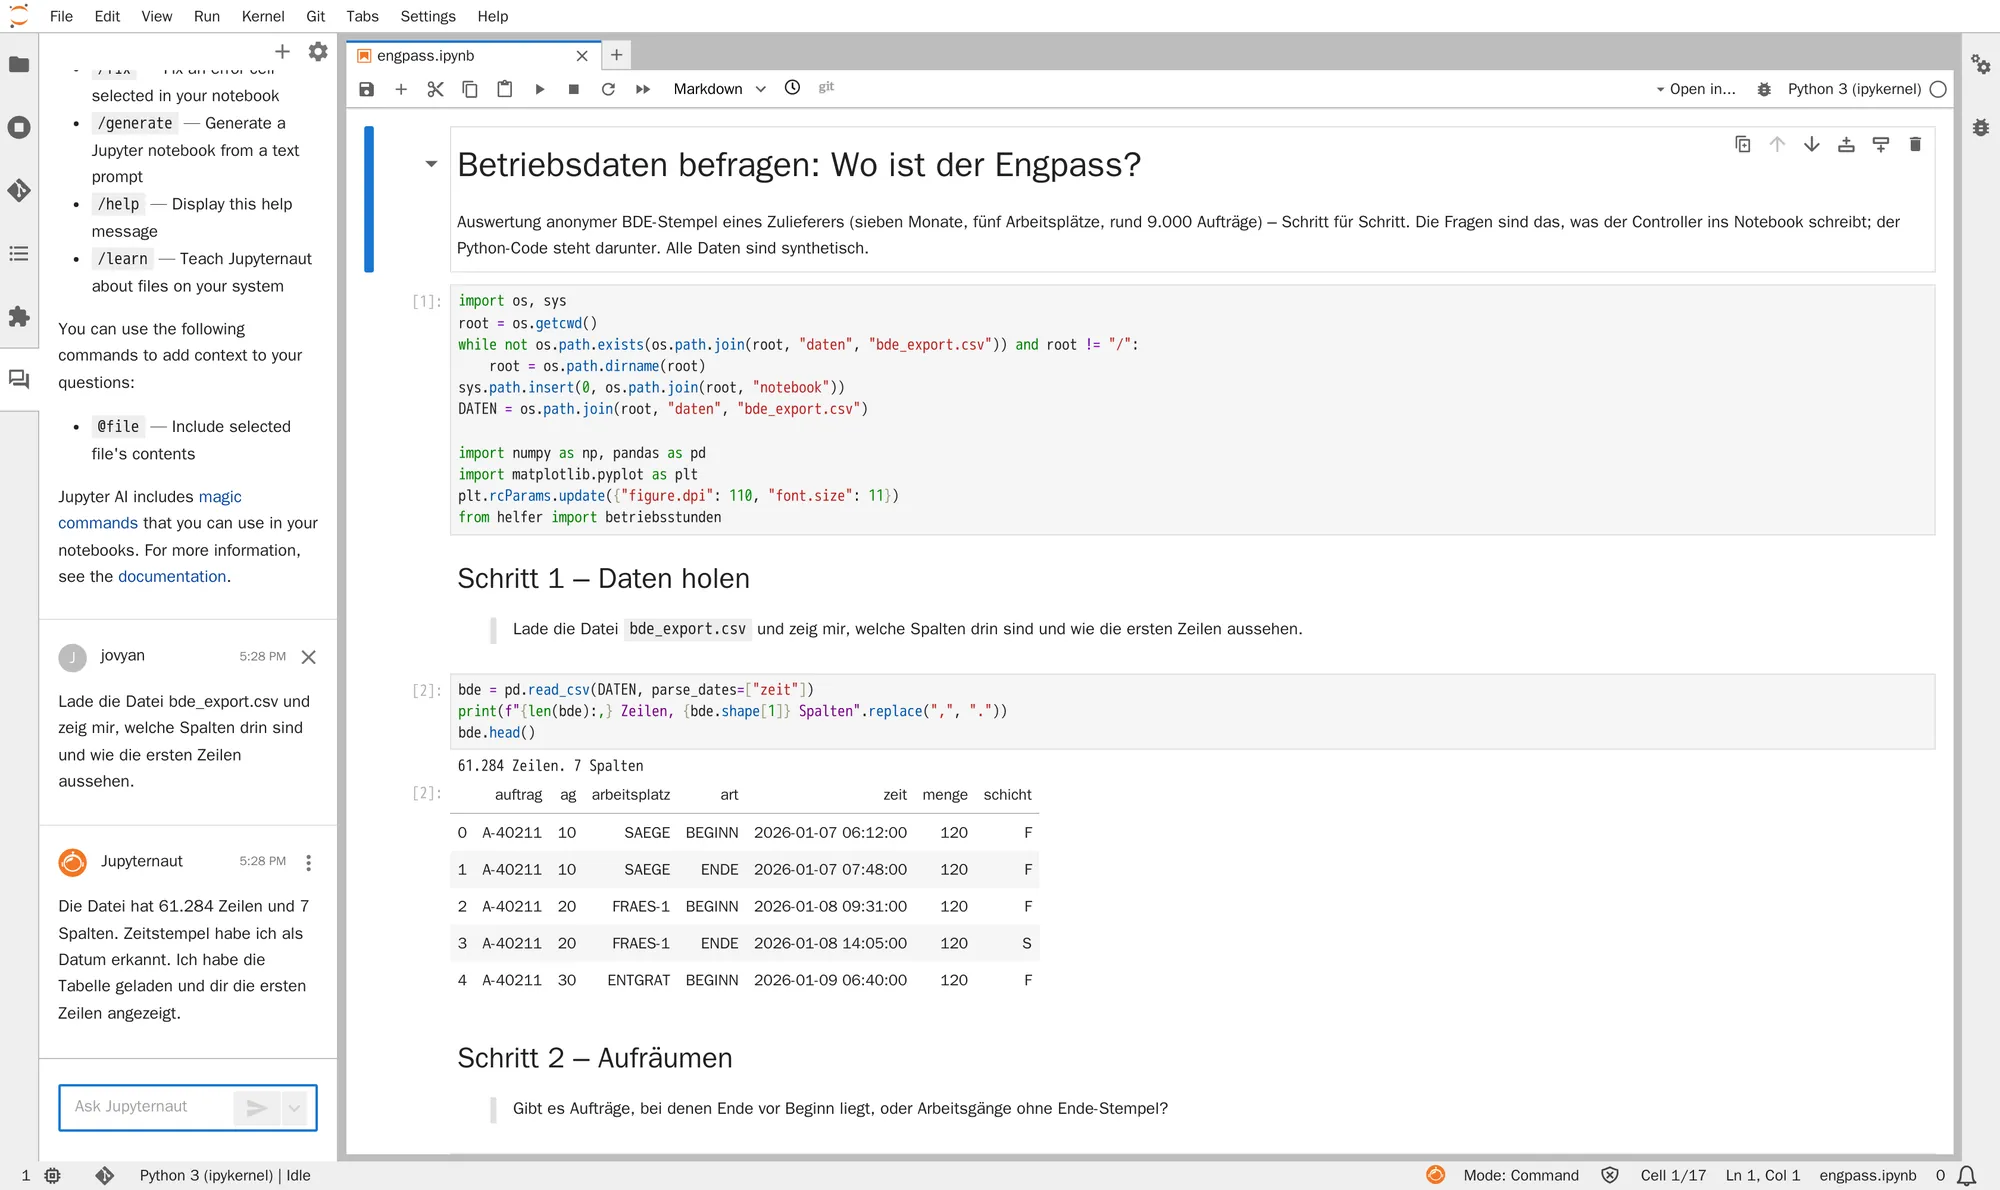
Schon die erste Antwort sagt etwas: Der Auftrag hat am 7. Januar um 7:48 die Säge verlassen und erst am 8. um 9:31 an der Fräse begonnen. 26 Stunden Liegezeit für einen Arbeitsgang, der viereinhalb Stunden dauert. Das ist ein einzelner Auftrag – die Frage ist, ob das die Regel ist.
Schritt 2
Die halbe Arbeit bei BDE-Daten ist, die Stempel zu entwirren. Das klingt nach Nebensache, ist aber einer der wichtigsten Schritte. Genau hier spart der Assistent am meisten – nicht, weil er die Regeln kennt, sondern weil man sie ihm in Sätzen geben kann und er sie in Sekunden auf alle Zeilen anwendet.
Jonas schreibt
Gibt es Aufträge, bei denen Ende vor Beginn liegt, oder Arbeitsgänge ohne Ende-Stempel?
Der Assistent
Ja: 212 Arbeitsgänge haben kein Ende, 38 haben Ende vor Beginn (vermutlich Tippfehler im Datum). Außerdem fällt auf: 1.140 Ende-Stempel liegen exakt auf 15:58 oder 15:59 – das sieht nach Sammelbuchung zum Schichtende aus. Soll ich die ausschließen oder markieren?
Jonas schreibt
Markieren. Ich frage den Meister, ob die nachgebucht werden. Die 38 mit Ende vor Beginn wirf raus.
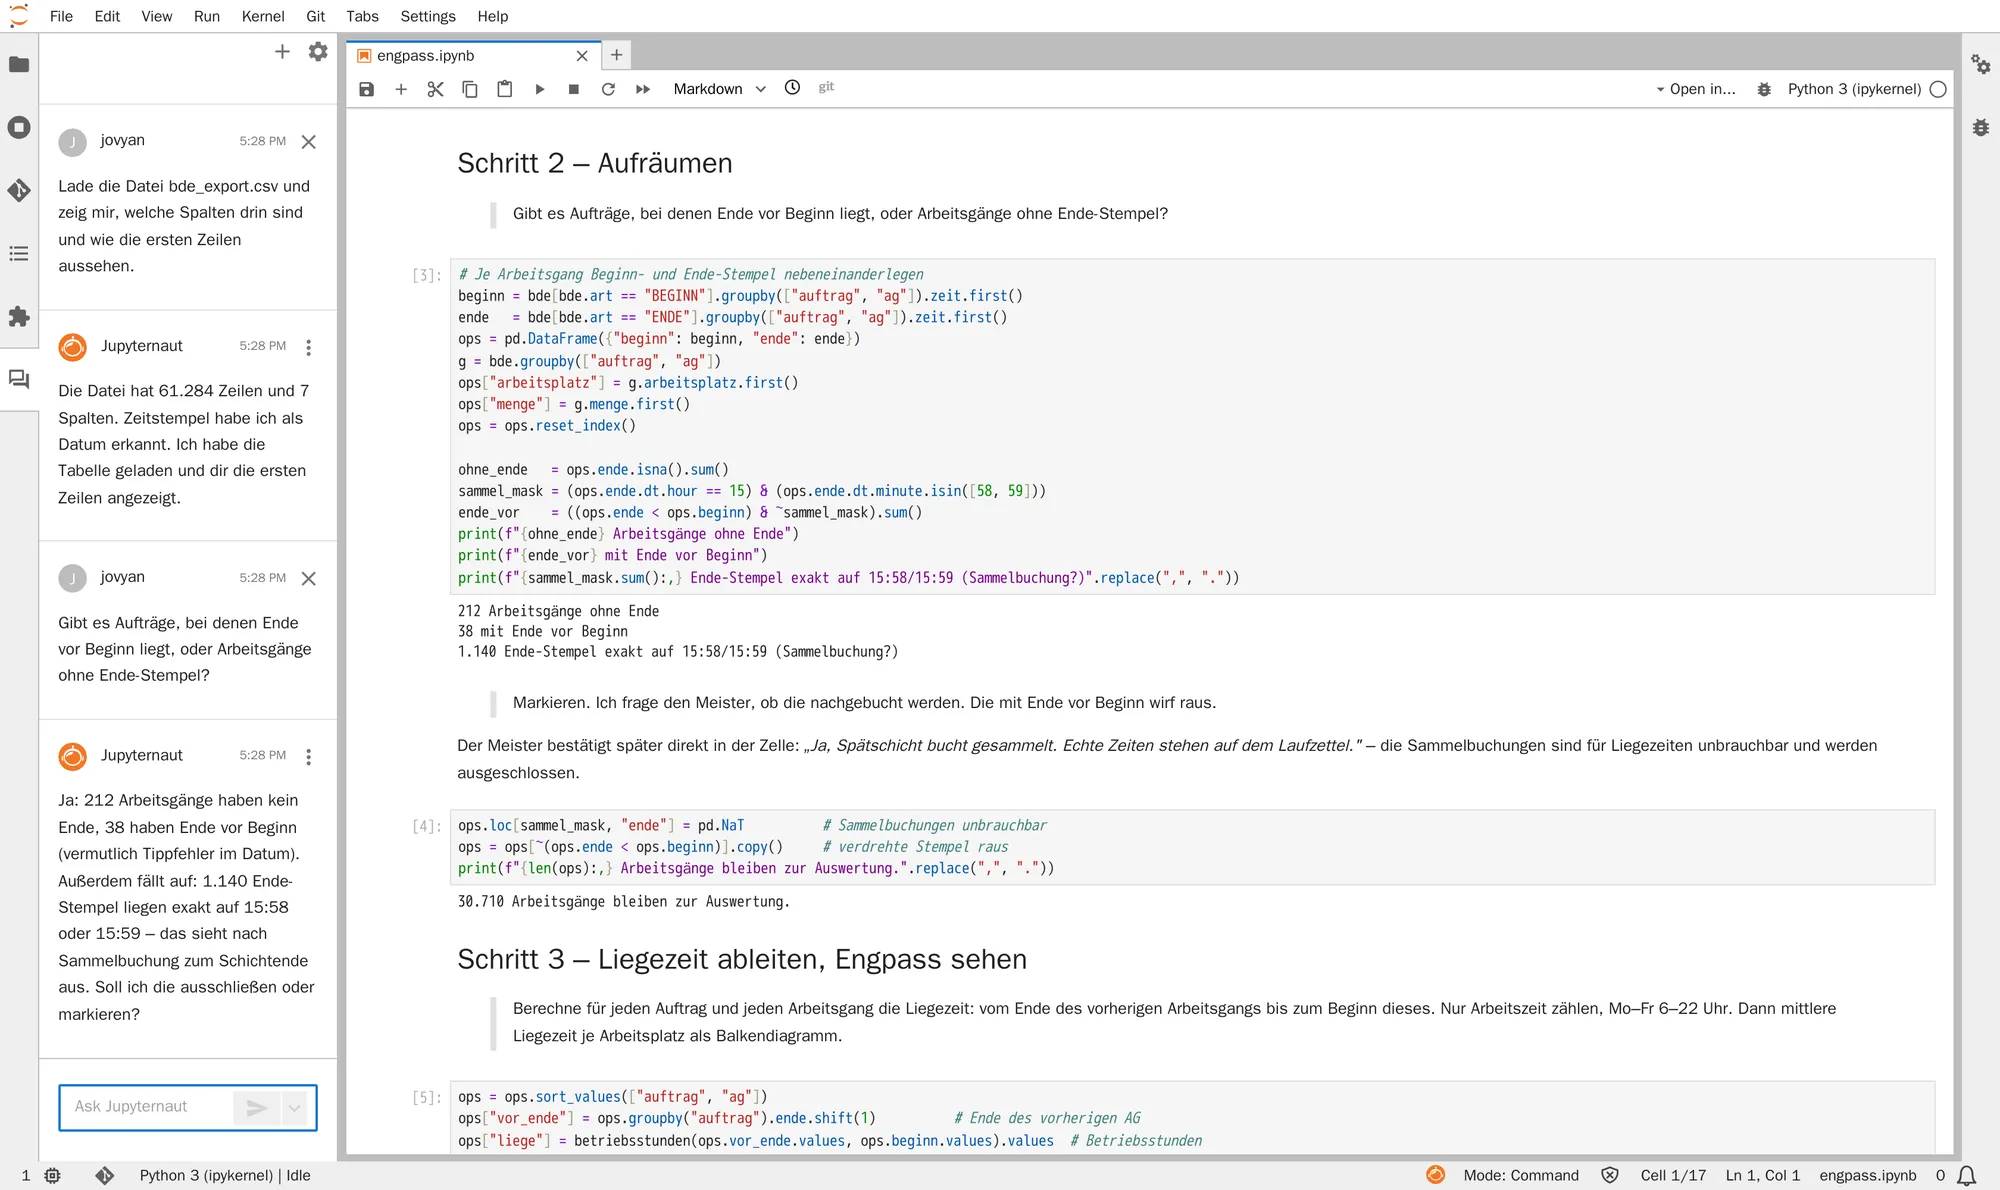
Das ist der Moment, in dem Teamarbeit anfängt. Jonas, der die Halle nur von Kennzahlen kennt, kann nicht wissen, ob 15:58 eine Sammelbuchung ist – der Meister weiß es in einer Sekunde. Die Rückfrage des Assistenten macht die Stelle sichtbar, an der Fachwissen fehlt, und das Notebook hält sie fest. Der Meister antwortet später per Kommentar direkt in der Zelle: „Ja, Spätschicht bucht gesammelt. Echte Zeiten stehen auf dem Laufzettel." Damit sind diese Stempel für Liegezeiten unbrauchbar und werden ausgeschlossen – eine Entscheidung, die dokumentiert im Notebook steht statt in einem Kopf.
Schritt 3
Jonas schreibt
Berechne für jeden Auftrag und jeden Arbeitsgang die Liegezeit: vom Ende des vorherigen Arbeitsgangs bis zum Beginn dieses. Nur Arbeitszeit zählen, Mo–Fr 6 bis 22 Uhr. Dann mittlere Liegezeit je Arbeitsplatz als Balkendiagramm.
Der Assistent
Ich rechne in Betriebsstunden, Wochenenden und Nächte sind abgezogen. Hier das Diagramm – ein Arbeitsplatz fällt deutlich heraus.
bde = bde.sort_values(["auftrag", "ag", "zeit"])
ende   = bde[bde.art == "ENDE"].set_index(["auftrag", "ag"]).zeit
beginn = bde[bde.art == "BEGINN"].set_index(["auftrag", "ag"]).zeit
vorher = ende.groupby(level=0).shift(1)        # Ende des vorherigen AG
liege  = betriebsstunden(vorher, beginn)       # eigene Hilfsfunktion
liege.groupby(bde.arbeitsplatz).mean().plot.barh()
Ergebnis · Mittlere Liegezeit vor dem Arbeitsplatz
Betriebsstunden. Vor FRAES-1 wartet ein Auftrag im Schnitt mehr als zwei Schichten; hinter ihm (ENTGRAT) fast gar nicht. SAEGE ist der erste Arbeitsgang und hat keinen Vorgänger – daher keine Liegezeit davor.
Das ist die Theory of Constraints in einem Diagramm: Vor dem Engpass stapelt sich Arbeit, hinter ihm wird sie sofort weiterverarbeitet. Niemand im Betrieb ist davon überrascht – „die Fräse ist immer voll" weiß jeder. Neu ist die Zahl: 18,4 Stunden, aus 9.000 Aufträgen, mit einer Rechnung, die jeder nachvollziehen kann.
Warum Warteschlangen sich so verhalten – und warum weniger Freigabe die Liegezeit senkt, ohne den Ausstoß zu verringern –, zeigt die Simulation:
Interaktiv · Warum sich vor dem Engpass Arbeit stapelt
Die anderen drei Stationen schaffen 5 je Stunde. Solange mehr freigegeben wird, als der Engpass schafft, wächst seine Schlange ohne Ende – und die Stationen dahinter warten auf Arbeit. Geben Sie weniger frei als der Engpass schafft: Die Liegezeit fällt überall, der Ausstoß bleibt gleich.
Schritt 4
Ein Mittelwert über sieben Monate verdeckt, was die Liegezeit treibt. Die nächste Frage ist deshalb, wann sie besonders hoch ist.
Jonas schreibt
Liegezeit vor FRAES-1 nach Wochentag der Freigabe und nach Losgröße (klein unter 50, mittel bis 200, groß darüber). Als Tabelle mit Farbe.
Der Assistent
Hier die Matrix. Zwei Muster sind klar: Montags ist die Wartezeit am höchsten, und große Lose warten deutlich länger als kleine.
Ergebnis · Liegezeit vor FRAES-1 in Betriebsstunden
Montag und große Lose: über 30 Stunden. Freitag und kleine Lose: unter 10. Dazwischen liegt der Hebel.
Hier zahlt sich das Notebook als gemeinsames Dokument aus. Jonas sieht die Matrix und hat eine Vermutung: Freitags werden Lose freigegeben, die erst Montag an der Fräse ankommen – und montags sind alle großen Lose zugleich fällig. Der Meister bestätigt einen Teil und ergänzt etwas, das in keiner Spalte steht: Montags ist der eine Einrichter, der FRAES-1 rüsten kann, in der Spätschicht. Das ist keine Maschinenkapazität, das ist eine Personenkapazität. Das Modell kann das nicht wissen. Das Team schon.
Schritt 5
Die Schritte 1 bis 4 macht ein Betriebswirt mit dem Assistenten selbst – Daten holen, aufräumen, die Kennzahl ableiten, nach dem Warum fragen. Das ist Auswertung: rückwärts gerichtet und gut nachvollziehbar. Ein Vorhersagemodell ist etwas anderes. Es soll für einen neuen Auftrag die zu erwartende Liegezeit nennen, bevor er freigegeben wird – und das ist eine echte Data-Science-Aufgabe: die richtigen Merkmale aus ERP, Artikelstamm und Schichtplan zusammenführen, ehrlich gegen ungesehene Zeiträume prüfen, Überanpassung vermeiden und das Modell über die Zeit am Laufen halten. Genau das übernehmen wir als KIMU.
Wie weit die Notebook-Sitzung allein schon trägt, zeigt ein erster Wurf mit Gradient Boosting auf Losgröße, Wochentag und Auslastung der Woche:
Jonas schreibt
Baue ein Modell, das die Liegezeit vor FRAES-1 aus Losgröße, Wochentag und Anzahl offener Aufträge vorhersagt. Trainiere auf Januar bis Mai, prüfe auf Juni und Juli. Wie gut ist es?
Der Assistent
Ich nehme Gradient Boosting, das kommt mit solchen Daten gut zurecht. Auf Juni/Juli liegt die Vorhersage im Mittel 3,2 Stunden neben der tatsächlichen Liegezeit. Zum Vergleich: Wer immer den Mittelwert 18,4 h annimmt, liegt 7,5 Stunden daneben. Die wichtigsten Merkmale sind Losgröße, Wochentag und die Zahl offener Aufträge.
from sklearn.ensemble import HistGradientBoostingRegressor
from sklearn.metrics import mean_absolute_error
X = merkmale(liege_fraes1)          # Losgröße, Wochentag, offene Aufträge
train, test = X[X.monat <= 5], X[X.monat >= 6]
modell = HistGradientBoostingRegressor().fit(train.drop(columns="liege"), train.liege)
mean_absolute_error(test.liege, modell.predict(test.drop(columns="liege")))
Mittlerer Fehler Juni/Juli: 3,2 h (Mittelwert-Regel: 7,5 h)
Was die beiden Zahlen bedeuten: Der mittlere Fehler von 3,2 h heißt, dass die Vorhersage für einen einzelnen Auftrag im Schnitt auf gut drei Stunden genau liegt – gemessen auf Juni und Juli, die das Modell beim Lernen nie gesehen hat. Das ist die ehrliche Prüfung; ein Modell, das nur auf den eigenen Trainingsdaten glänzt, sagt nichts. Wer stattdessen stur die durchschnittlichen 18,4 h für jeden Auftrag annimmt, liegt 7,5 h daneben – der Modellfehler ist damit weniger als halb so groß wie bei dieser einfachsten Faustregel.
Berauschend ist das noch lange nicht. 3,2 Stunden sind bei einer mittleren Wartezeit von 18 Stunden eine ordentliche Spanne, und es ist ein erster Wurf aus nur drei Merkmalen. Der Sprung nach vorn kommt mit dem, was noch fehlt – Rüstfamilie, Materialverfügbarkeit, der eine Einrichter, der nur montags da ist – und mit mehr, sauber zusammengeführten Daten aus ERP und Schichtplan.
Und damit wird sie konkret für die Arbeitsvorbereitung: Steht bei jeder Freigabe die erwartete Liegezeit vor dem Engpass, zieht die AV große Lose aus dem Montag heraus, setzt belastbarere Liefertermine und erkennt früh, wenn eine Woche überläuft. Aus der einmaligen Auswertung wird ein Werkzeug im Tagesgeschäft – und dieses Modell aufzubauen, sauber abzunehmen und über die Zeit zu betreuen, ist die Data-Science-Arbeit, die wir übernehmen.
Zusammenarbeit
Schnell wird dieser Ablauf durch die KI – das muss man so sagen. Vor zwei Jahren hätte Jonas für jede der fünf Fragen einen Entwickler gebraucht, der Tage später eine Auswertung liefert, die die Frage nicht ganz trifft; die nächste Frage wäre wieder in die Warteschlange gegangen. Heute stellt er sie selbst, sieht das Ergebnis in Sekunden und stellt die nächste. Aus Tagen werden Minuten, deshalb ist das Ganze in einer Woche durch.
Was die KI nicht liefert, ist die richtige Frage und die richtige Deutung. Und dafür braucht es drei Leute, die sich sonst nur über Kennzahlen streiten, hier aber dieselbe Zelle kommentieren:
Das Notebook liegt auf einem gemeinsamen Server, im Haus oder in Europa. Jeder öffnet es im Browser, sieht denselben Stand, und die Geschichte bleibt erhalten: welche Stempel ausgeschlossen wurden, warum, von wem. Eine Woche nach dem Export gibt es ein Diagramm für die Geschäftsführung und ein Modell für die Arbeitsvorbereitung.
Der Engpass stand sieben Monate lang in den Stempeln. Es fehlte nicht an Daten, sondern an jemandem, der die Frage stellen konnte, ohne vorher programmieren zu lernen. Das gilt für jede andere Frage an die Fertigung genauso.
Ehrlichkeit
Stempeldisziplin. Liegezeit aus BDE ist nur so gut wie die Stempel. Wer abends sammelt, produziert Scheinwartezeiten; wer morgens vorstempelt, versteckt sie. Der Aufräumschritt ist deshalb keine Formalität – er entscheidet, ob die Zahlen etwas bedeuten.
Korrelation. Das Modell findet, dass Montag und große Lose zusammen lange Wartezeiten ergeben. Es findet nicht, dass der Grund ein Einrichter in der Spätschicht ist. Die Ursache liefert der Mensch, der an der Maschine steht.
Wandernde Engpässe. Wer den Engpass an FRAES-1 entschärft, findet den nächsten an FRAES-2. Das ist kein Scheitern, das ist der Mechanismus. Deshalb sollte der Export wöchentlich laufen und das Notebook wiederholbar sein.
Einordnung
Fünf Arbeitsplätze, eine Datei, ein Engpass im Balkendiagramm: So glatt ist es in der Praxis nie. Echte BDE-Daten haben Parallelarbeitsplätze, Teilmengen, Nacharbeit, übersprungene Arbeitsgänge und drei Buchungslogiken, weil das System zweimal gewechselt wurde. Die Merkmale fürs Modell kommen aus ERP, Artikelstamm und Schichtplan und müssen erst zusammengeführt werden. Rechnen Sie mit zwei bis drei Wochen statt einer – und damit, dass der erste Engpass, den Sie finden, ein Buchungsfehler ist.
Und eine Grenze gehört benannt: Das Notebook wertet aus, was war, und das Modell sagt vorher, was unter ähnlichen Bedingungen wahrscheinlich wird. Es spielt nicht durch, was eine andere Reihenfolge, eine verschobene Schicht oder eine zweite Maschine bewirken würde. Dafür braucht es einen digitalen Zwilling der Fertigung – eine eigene Disziplin mit eigenen Werkzeugen, und nicht unsere Welt. Das Notebook liefert die Vorstufe: bereinigte Daten, gemessene Liegezeiten, einen Engpass, den man beim Zwillingsbau nicht erst suchen muss.
Der Ansatz ändert sich durch all das nicht. Daten holen, aufräumen, die Kennzahl ableiten, fragen, warum, vorhersagen, prüfen – in einem Notebook, das ein Betriebswirt bedient und ein Meister kommentiert. Und die Liegezeit ist nur ein Beispiel. Mit derselben Kette lassen sich Rüstzeiten, Ausschussquoten, Termintreue je Lieferant oder der Energieverbrauch je Charge befragen. Die Fragen ändern sich, das Notebook nicht.
Wer das nicht allein aufsetzen will: Wir bauen den Stack auf – JupyterLab mit KI-Assistent im Haus oder in Europa, dazu einen Flow, der die Stempel live aus ERP und BDE zieht, sodass das Notebook jeden Montag mit frischen Daten startet. Wir schulen den Umgang mit KI und Jupyter, damit Controlling und Arbeitsvorbereitung die Fragen selbst stellen. Und wenn die Vorhersage in den Leitstand soll – automatisch bei jeder Freigabe, für alle Arbeitsplätze, mit Nachlernen aus neuen Stempeln –, machen wir aus dem Notebook eine laufende Pipeline. Das Notebook bleibt die Spezifikation, die das Team selbst geschrieben hat.
Ein Anruf genügt für eine belastbare Einschätzung: ob er sich automatisieren lässt, was das kostet – und ob er sich überhaupt trägt.